
คำถามที่คนใช้ AI ช่วยเขียนโค้ดถามกันมากที่สุดไม่ใช่ว่าโมเดลเก่งแค่ไหน แต่เป็น งานหนึ่งชิ้นจะโดนเรียกเก็บเงินเท่าไร ซึ่งตอบยากกว่าที่คิด เพราะราคาต่อ token เป็นแค่ตัวแปรเดียวในสมการ ที่เหลืออยู่ที่วิธีทำงานของเราเองล้วน ๆ
บทความนี้ทีมงาน IT Genius เรียบเรียงขึ้นใหม่เป็นภาษาไทย โดยอ้างอิงเนื้อหาและตัวเลขจากบทความ What a task costs on Opus 5.5 ของ Anthropic เขียนใหม่ให้คนที่เพิ่งเริ่มใช้ AI ทำงานอ่านรู้เรื่อง พร้อมกราฟประกอบภาษาไทยที่เราทำขึ้นเองจากตัวเลขในบทความต้นฉบับ อ่านจบแล้วคุณจะรู้ว่าเงินหายไปทางไหน และลดได้ตรงจุดไหนบ้าง
ทำไมราคาต่อ token ถึงบอกอะไรไม่ได้เลย
เวลาเห็นข่าวว่าโมเดลใหม่ถูกลง 20% หลายคนคิดว่าบิลเดือนหน้าจะลดลง 20% ตามไปด้วย ความจริงไม่ใช่แบบนั้น เพราะสิ่งที่เราจ่ายจริงคือ ราคาต่อ token คูณด้วยจำนวน token ที่งานนั้นกินไปทั้งหมด และตัวคูณที่สองนี้แกว่งได้หลายเท่าตัวจากปัจจัยที่เราควบคุมเอง
ปัจจัยที่ทำให้คนสองคนทำงานเหมือนกันแต่จ่ายไม่เท่ากัน มีอยู่ไม่กี่ข้อ
- จำนวนรอบที่คุยกัน (turns) ทุกรอบต้องส่งบทสนทนาทั้งหมดกลับไปใหม่ ยิ่งคุยหลายรอบยิ่งจ่ายซ้ำ
- อัตราการใช้แคช (cache hit rate) ข้อความเดิมที่เคยส่งไปแล้ว ถ้ายังอยู่ในแคชจะคิดราคาถูกกว่ามาก
- ปริมาณ output รวมถึงส่วนที่โมเดลใช้คิด ซึ่งถูกคิดเงินเป็น output ทั้งหมด
- โมเดลที่เลือกใช้ ราคาต่างกันได้หลายเท่าระหว่างรุ่นเล็กกับรุ่นใหญ่
- ระดับความพยายาม (effort) ยิ่งสั่งให้คิดละเอียด ยิ่งกิน token มาก
สังเกตว่ามีแค่ข้อเดียวที่เกี่ยวกับราคาโมเดล อีกสี่ข้อคือพฤติกรรมการใช้งานทั้งนั้น
Opus 5.5 ถูกลงตรงไหนบ้าง
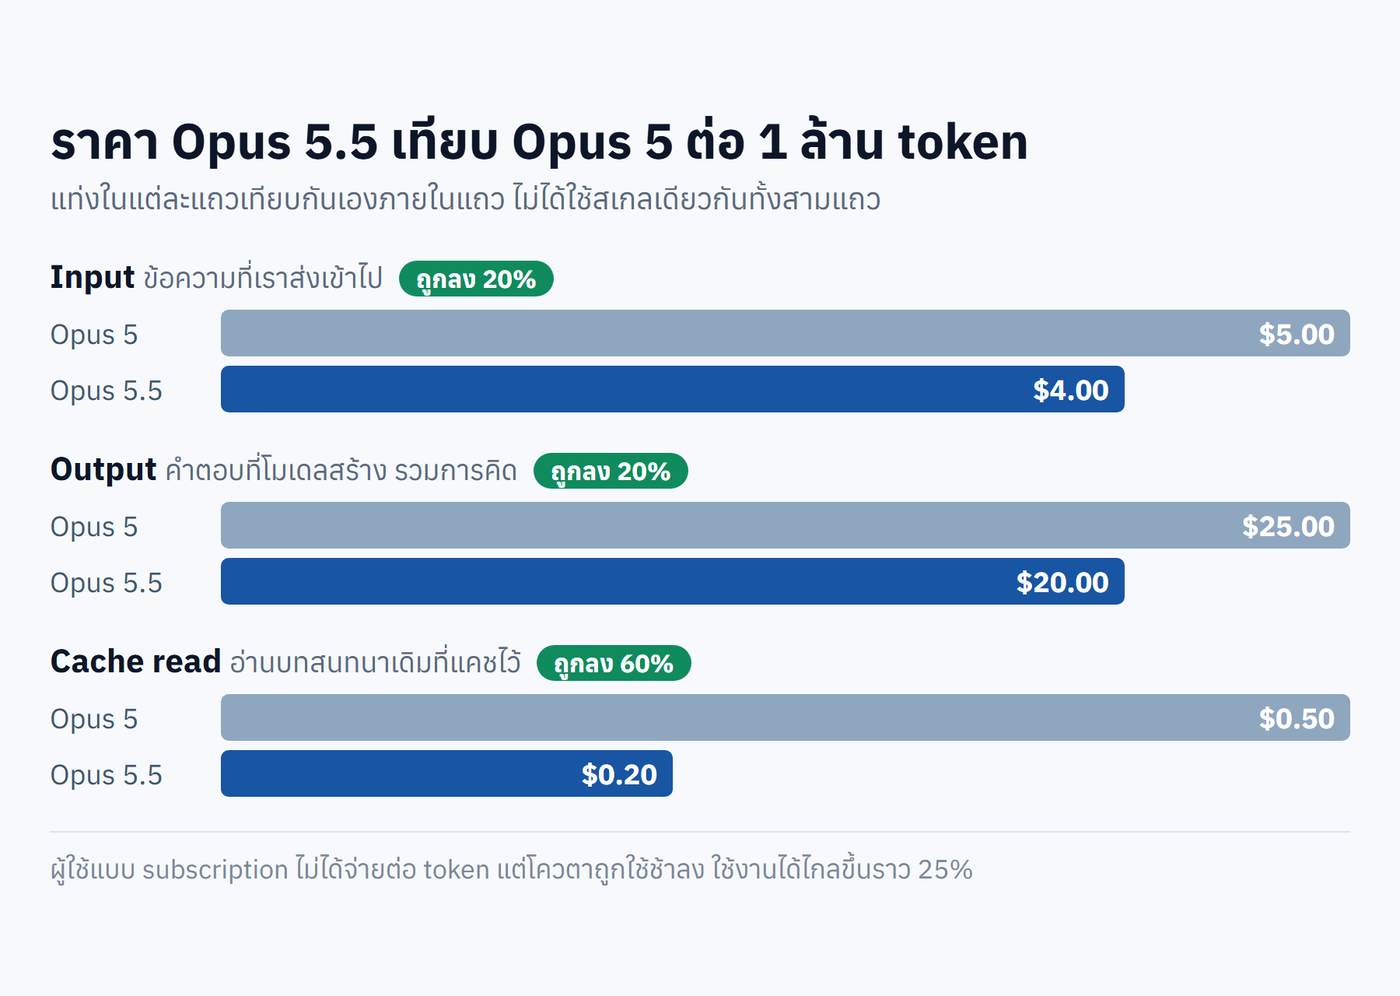
ตัวเลขน่าสนใจที่สุดไม่ใช่ input หรือ output แต่เป็น ราคาอ่านจากแคชที่ถูกลงถึง 60% จาก 0.50 ดอลลาร์เหลือ 0.20 ดอลลาร์ต่อล้าน token เหตุผลคือในงานจริงที่คุยกันยาว ๆ token ส่วนใหญ่ที่ถูกส่งไปคือบทสนทนาเดิมที่อ่านซ้ำ ไม่ใช่ข้อความใหม่ การที่ส่วนนี้ถูกลงเกินครึ่งจึงกระทบบิลมากกว่าตัวเลข 20% ที่เห็นในสองรายการแรก
สำหรับคนที่ใช้แบบ subscription รายเดือน ไม่ได้จ่ายต่อ token อยู่แล้ว ผลที่ได้คือโควตาถูกใช้ช้าลง ใช้งานได้ไกลขึ้นราว 25% ก่อนจะชนเพดาน
ต้นทุนหนึ่ง session ประกอบด้วยอะไร
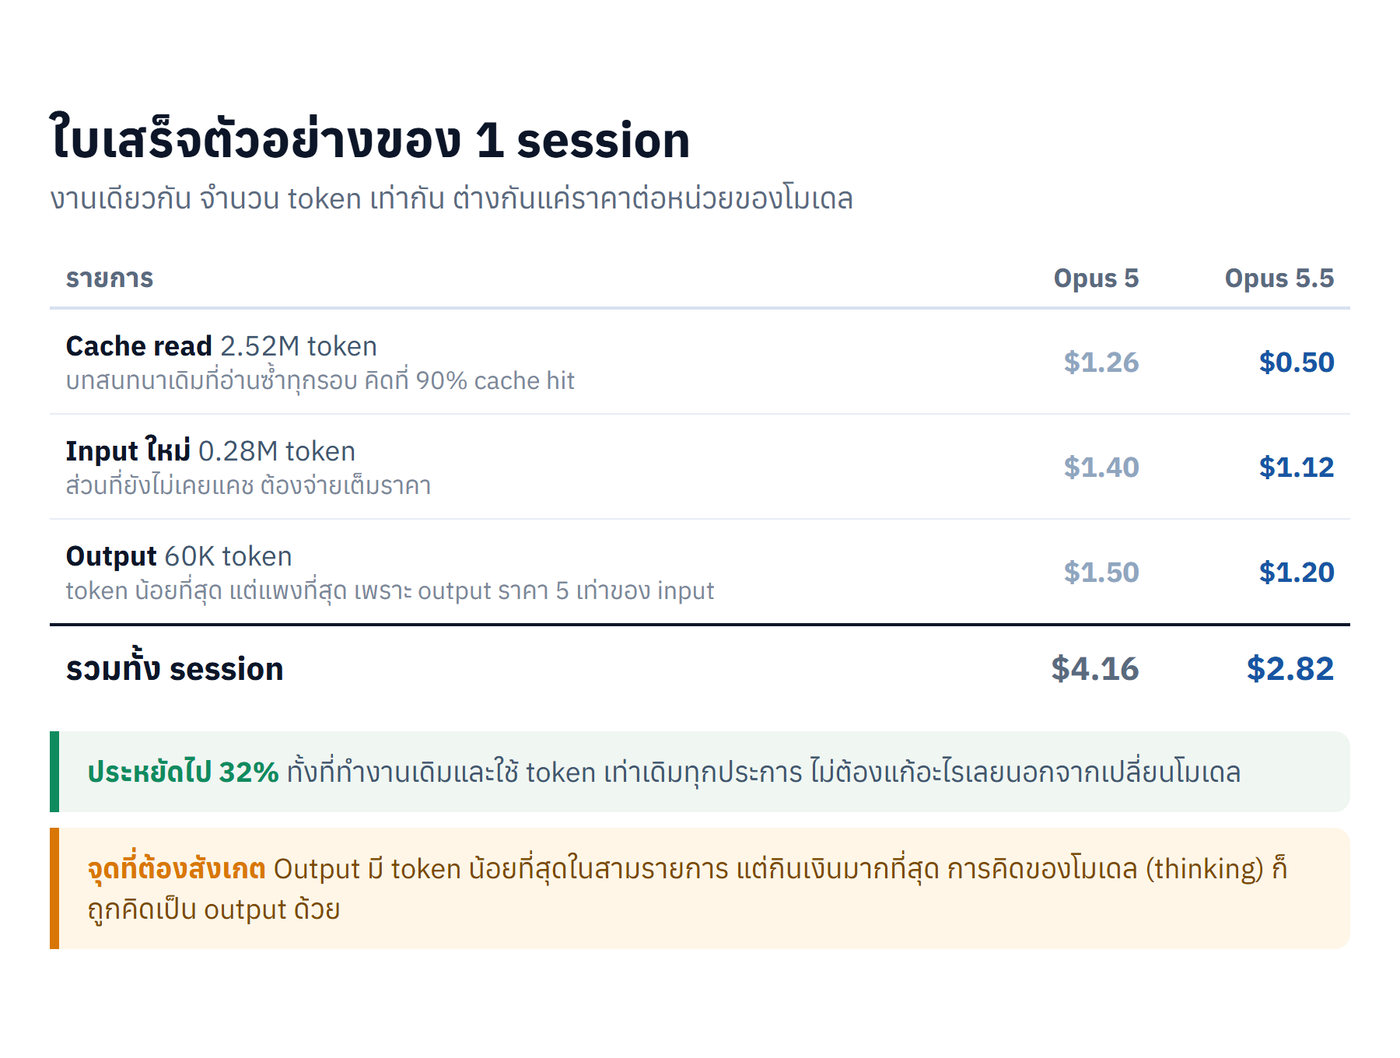
ใบเสร็จนี้คือ session เดียวกันเป๊ะ จำนวน token เท่ากันทุกบรรทัด ต่างกันแค่ราคาต่อหน่วยของโมเดล ผลคือจาก 4.16 ดอลลาร์เหลือ 2.82 ดอลลาร์ ประหยัดไป 32% โดยไม่ต้องแก้อะไรเลย
สิ่งที่มือใหม่มักตกใจคือบรรทัดสุดท้าย Output มี token น้อยที่สุดในสามรายการ แต่กินเงินมากที่สุด เพราะราคา output แพงกว่า input ถึง 5 เท่า และการที่โมเดลนั่งคิดก่อนตอบก็ถูกนับเป็น output ด้วย นี่คือเหตุผลที่การสั่งให้โมเดลคิดละเอียดเกินความจำเป็นแพงกว่าที่คิดมาก
แคชคือตัวแปรที่คนมองข้ามมากที่สุด
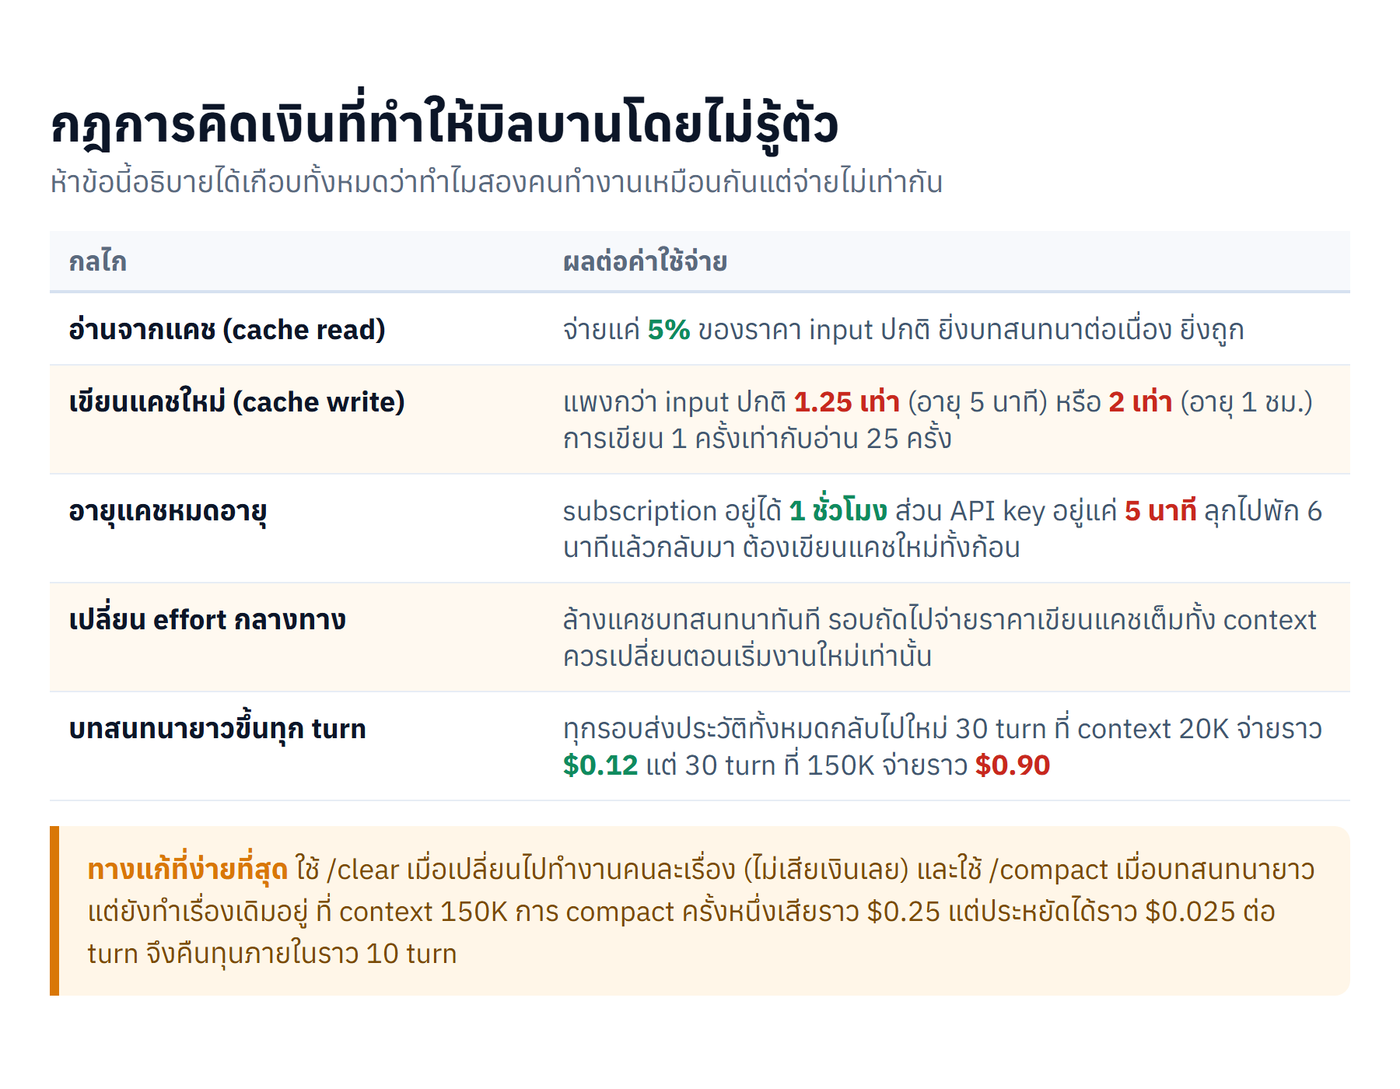
กฎห้าข้อนี้อธิบายได้เกือบทั้งหมดว่าทำไมบางวันบิลพุ่งขึ้นมาโดยไม่มีเหตุผลชัดเจน จุดที่เจ็บที่สุดคือ การเขียนแคชหนึ่งครั้งแพงเท่ากับการอ่าน 25 ครั้ง แปลว่าถ้าคุณลุกไปกินข้าว 10 นาทีแล้วกลับมาคุยต่อ ระบบต้องเขียนแคชใหม่ทั้งก้อน ค่าใช้จ่ายรอบนั้นจะกระโดดขึ้นทันที
อายุแคชก็ต่างกันตามวิธีที่ใช้ ผู้ใช้แบบ subscription แคชอยู่ได้ 1 ชั่วโมงซึ่งสบายมาก แต่คนที่ยิงผ่าน API key แคชอยู่แค่ 5 นาที การพักเบรกสั้น ๆ จึงมีราคาจริงสำหรับกลุ่มหลัง
Effort คืออะไร และควรตั้งไว้ที่เท่าไร
Effort คือระดับความละเอียดที่เราสั่งให้โมเดลคิดก่อนตอบ มีห้าระดับคือ low, medium, high, xhigh และ max โดย Opus 5.5 ตั้งค่าเริ่มต้นไว้ที่ medium ซึ่งต่ำลงมาหนึ่งขั้นจากรุ่นก่อนที่ตั้งไว้ที่ high ตรงนี้เป็นเหตุผลหนึ่งที่ค่าใช้จ่ายลดลงตั้งแต่ยังไม่ได้ปรับอะไร
แนวทางเลือกระดับที่ใช้ได้จริง
- low สำหรับงานกลไกล้วน ๆ เช่น เปลี่ยนชื่อตัวแปรทั้งโปรเจกต์ หรือทำตามแพตเทิร์นที่มีอยู่แล้ว
- medium สำหรับงานประจำวันที่โจทย์ชัดเจน ใช้เป็นค่าเริ่มต้นได้เลย
- high ขยับขึ้นมาเมื่อ medium แล้วไปต่อไม่ได้ ระดับนี้เพิ่ม token ที่ใช้คิดราว 20,000 token ต่องาน คิดเป็นเงินราว 0.40 ดอลลาร์บน Opus 5.5
- max เก็บไว้ใช้เฉพาะงานที่ความถูกต้องสำคัญกว่าค่าใช้จ่าย และใช้เป็นครั้ง ๆ ไป
ข้อควรระวังที่สำคัญคือ การเปลี่ยน effort กลางบทสนทนาจะล้างแคชทิ้งทันที รอบถัดไปต้องจ่ายค่าเขียนแคชเต็มทั้ง context ถ้าจะเปลี่ยนควรเปลี่ยนตอนเริ่มงานใหม่ ไม่ใช่เปลี่ยนไปมาระหว่างทาง
เลือกโมเดลให้ถูกกับงาน
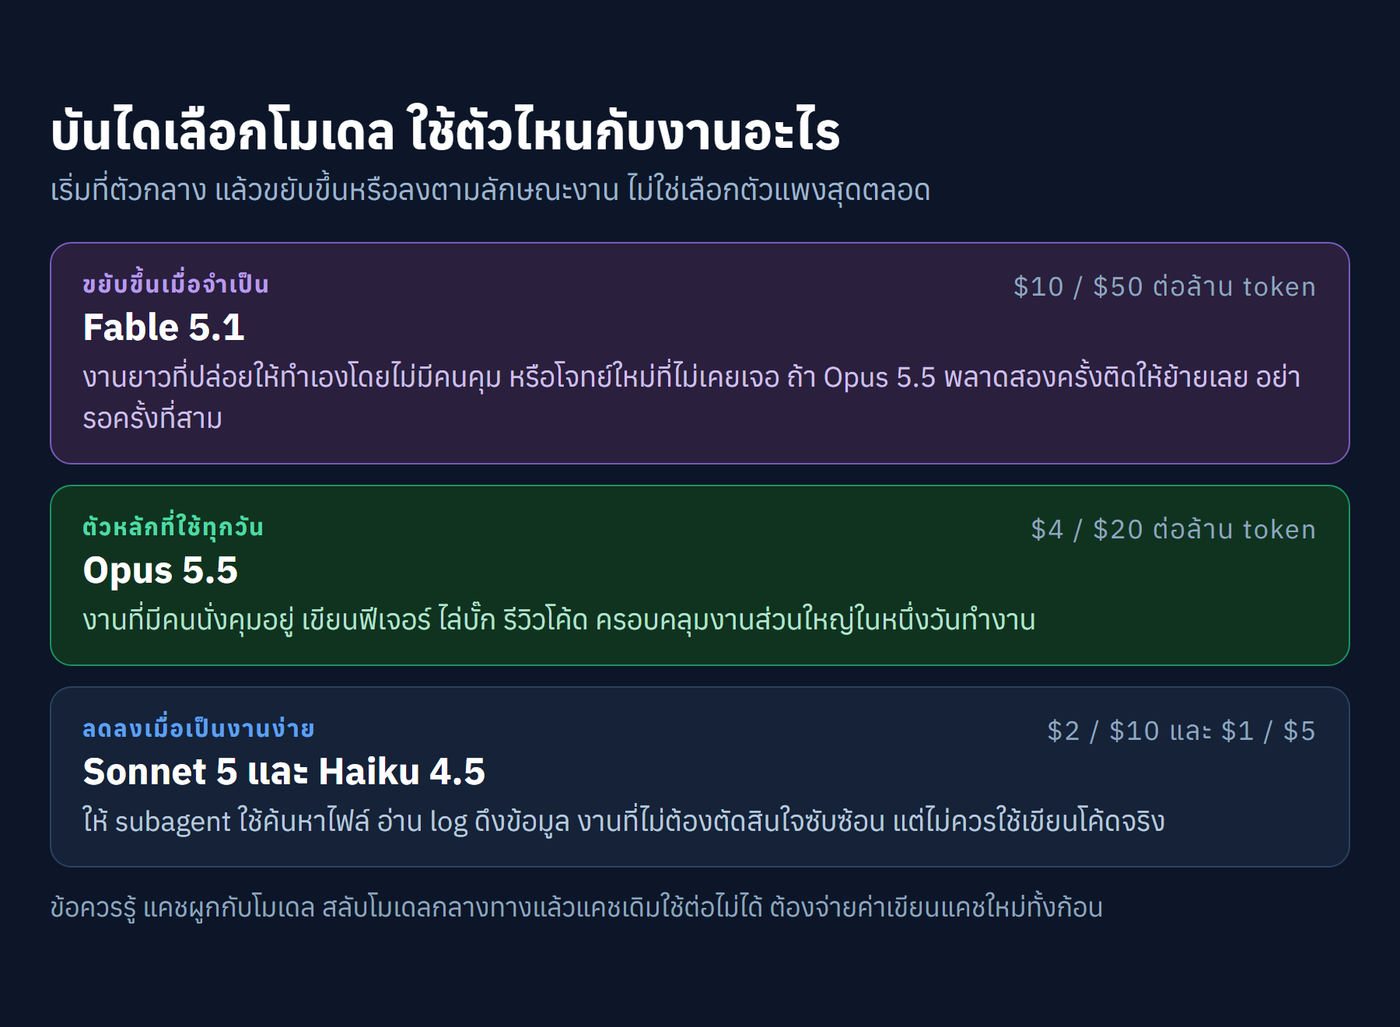
หลักคิดคือเริ่มที่ตัวกลางแล้วขยับตามลักษณะงาน ไม่ใช่เลือกตัวแพงที่สุดตลอดเวลาเพราะคิดว่าปลอดภัยกว่า
จุดที่ควรจำคือเกณฑ์ตัดสินใจขยับขึ้น ถ้า Opus 5.5 ทำงานหนึ่งพลาดติดกันสองครั้ง ให้ย้ายไปใช้ Fable 5.1 เลย อย่ารอให้พลาดครั้งที่สาม เพราะค่า retry สามรอบมักแพงกว่าการใช้โมเดลที่แรงกว่าตั้งแต่รอบแรก
ส่วนขาลง งานประเภทค้นหาไฟล์ อ่าน log หรือดึงข้อมูลมาสรุป ควรมอบให้ subagent ที่ใช้โมเดลเล็กกว่า ตั้งได้ผ่าน model: haiku ในนิยาม subagent หรือกำหนดที่ตัวแปรสภาพแวดล้อม CLAUDE_CODE_SUBAGENT_MODEL แต่ไม่ควรให้โมเดลเล็กเขียนโค้ดจริง
ย้ายโมเดลแล้วยังลดได้อีกจากการรื้อ prompt
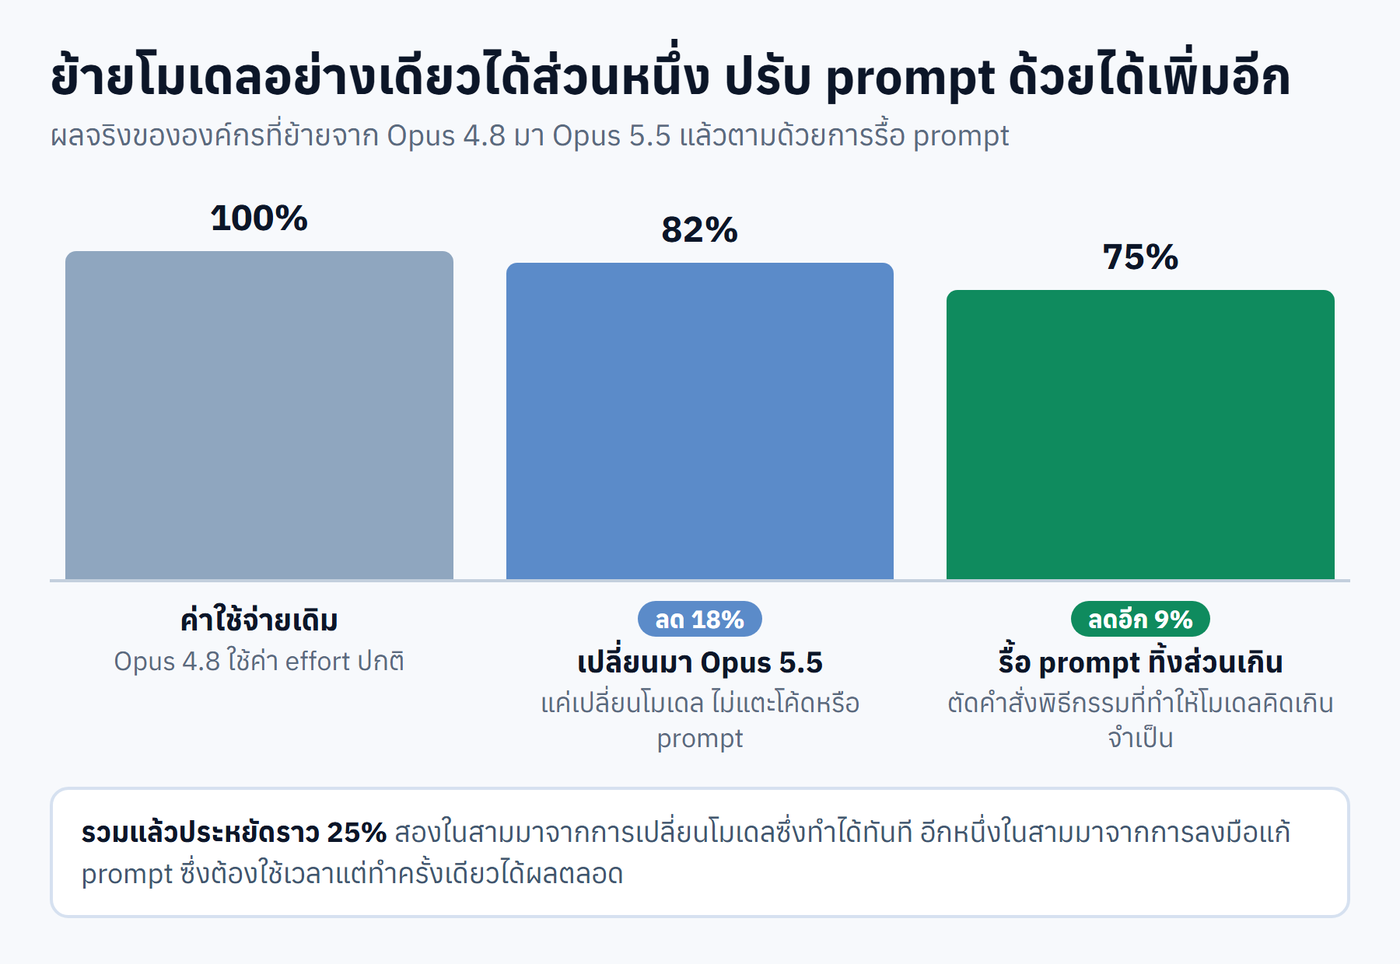
นี่คือผลจริงขององค์กรที่ย้ายจาก Opus 4.8 มา Opus 5.5 การเปลี่ยนโมเดลอย่างเดียวลดไป 18% ซึ่งได้มาฟรี ๆ แต่พอลงมือรื้อ prompt ต่อ ลดเพิ่มได้อีก 9% รวมแล้วประหยัดราว 25%
สิ่งที่ต้องรื้อออกคือคำสั่งที่เขียนไว้สมัยโมเดลรุ่นเก่าแล้วไม่จำเป็นอีกแล้ว เช่น บังคับให้ทำตามขั้นตอนหลายชั้นทุกครั้ง สั่งให้จดกระดาษทดก่อนตอบ หรือคำสั่งที่ขัดแย้งกันเองจนโมเดลต้องคิดวนเพื่อหาทางออก คำสั่งพวกนี้เคยช่วยได้จริงกับโมเดลรุ่นก่อน แต่กับรุ่นใหม่กลายเป็นภาระที่ทำให้เปลือง token เฉย ๆ
เคล็ดลับลดค่าใช้จ่ายที่ทำได้ทันที
รวบรวมเฉพาะข้อที่เห็นผลเร็วและไม่ต้องแก้ระบบอะไรเลย
- ใช้ /clear เมื่อเปลี่ยนไปทำงานคนละเรื่อง คำสั่งนี้ไม่เสียเงินเลย แต่ตัดบทสนทนาเก่าที่ไม่เกี่ยวข้องออกจากการส่งซ้ำทุกรอบ
- ใช้ /compact เมื่อยังทำเรื่องเดิมแต่คุยกันยาวแล้ว ที่ context ราว 150,000 token การ compact เสียราว 0.25 ดอลลาร์ แต่ประหยัดได้ราว 0.025 ดอลลาร์ต่อรอบ จึงคืนทุนภายในราว 10 รอบ
- ทำให้ไฟล์ CLAUDE.md สั้นกว่า 200 บรรทัด เพราะไฟล์นี้ถูกโหลดเข้าไปทุกรอบที่คุย ยาวเกินจำเป็นคือจ่ายซ้ำทุกรอบ
- ตัด MCP server ที่ไม่ได้ใช้ออก ใช้คำสั่ง
/mcpดูว่าต่ออะไรค้างไว้บ้าง ทุกตัวที่ต่ออยู่กินพื้นที่ context และการต่อหรือตัดกลางทางยังทำให้ต้องเขียนแคชใหม่ด้วย - ให้โมเดลมีวิธีตรวจงานตัวเอง เช่น มีเทสต์ มีสคริปต์ build หรือสคริปต์ตรวจความถูกต้อง เพราะการจับผิดได้เร็วถูกกว่าปล่อยให้ทำผิดทางยาวแล้วต้องย้อนกลับมาแก้
- รวบคำสั่งให้จบในรอบเดียว บอกบริบทที่จำเป็นให้ครบตั้งแต่แรก ดีกว่าถามทีละนิดแล้วต้องวนหลายรอบ เพราะทุกรอบคือการส่งบทสนทนาทั้งหมดกลับไปใหม่
- ทำงานให้ต่อเนื่อง อย่าทิ้งช่วงนาน แคชที่ยังอุ่นอยู่ราคาถูกกว่าแคชที่ต้องเขียนใหม่หลายเท่า
วัดค่าใช้จ่ายของตัวเองยังไง
อย่าเดา ให้วัด วิธีที่ง่ายที่สุดคือพิมพ์คำสั่ง /usage เมื่อทำงานเสร็จหนึ่งชิ้น แล้วดูสามตัวเลขนี้
- สัดส่วนที่มาจากแคช ถ้าคุยกันยาวแล้วตัวเลขนี้ยังต่ำ แปลว่ามีอะไรทำให้แคชหลุด อาจเป็นการพักนาน หรือเปลี่ยนการตั้งค่ากลางทาง
- อัตราส่วน output ต่อ input ถ้าแก้โค้ดนิดเดียวแต่ output สูงผิดปกติ แปลว่า effort สูงเกินไป หรือมีการลองผิดลองถูกวนหลายรอบ
- input รวมเทียบกับขนาดบทสนทนา ถ้า input รวมเป็นหลายเท่าของขนาดบทสนทนา แปลว่าคุยกันหลายรอบเกินจำเป็น
ถ้าอยากเทียบให้เห็นชัด ให้ลองทำงานชิ้นเดียวกันสองครั้งด้วยโมเดลคนละตัว แล้วเอาตัวเลขมาวางข้างกัน สำหรับทีม มี Claude Code Analytics API และ Usage and Cost API ให้ดึงข้อมูลรายคนออกมาดูได้
ตัวเลขอ้างอิงจากองค์กรจริง
สำหรับคนที่ไม่รู้ว่าใช้เท่าไรถึงเรียกว่าเยอะ Anthropic ให้ตัวเลขอ้างอิงจากลูกค้าองค์กรไว้ว่า
- ค่าเฉลี่ยอยู่ที่ราว 13 ดอลลาร์ต่อนักพัฒนาหนึ่งคนต่อหนึ่งวันที่ใช้งานจริง
- กลุ่มที่ใช้หนักระดับเปอร์เซ็นไทล์ที่ 90 ยังอยู่ ต่ำกว่า 30 ดอลลาร์ต่อวัน
ตัวเลขนี้ใช้เป็นเส้นเทียบได้ ถ้า session ไหนของคุณสูงกว่าค่าปกติของตัวเองมาก ๆ นั่นคือสัญญาณให้ย้อนกลับไปดูว่าเกิดอะไรขึ้น ไม่ใช่ปล่อยผ่าน
สรุปสำหรับมือใหม่
- ราคาต่อ token ไม่ใช่คำตอบทั้งหมด ค่าใช้จ่ายจริงคือราคาคูณด้วยจำนวน token ที่งานนั้นกิน ซึ่งเราควบคุมได้
- Opus 5.5 ถูกลงจาก Opus 5 input และ output ถูกลงอย่างละ 20% ส่วนการอ่านจากแคชถูกลง 60%
- Output แพงกว่า input 5 เท่า และการที่โมเดลนั่งคิดก็ถูกคิดเป็น output ด้วย
- แคชคือพระเอก อ่านจากแคชจ่ายแค่ 5% ของราคาปกติ แต่การเขียนแคชหนึ่งครั้งแพงเท่าอ่าน 25 ครั้ง ทำงานต่อเนื่องจึงถูกกว่าทำ ๆ หยุด ๆ
- effort เริ่มที่ medium ก็พอ ขยับขึ้นเมื่อจำเป็นจริง และอย่าเปลี่ยนกลางบทสนทนาเพราะแคชจะโดนล้าง
- เลือกโมเดลให้ตรงงาน ตัวกลางใช้ทุกวัน ตัวแรงไว้งานยากที่ปล่อยให้ทำเอง ตัวเล็กไว้ค้นหาและอ่าน log
- /clear ฟรี /compact คืนทุนใน 10 รอบ สองคำสั่งนี้คือเครื่องมือลดค่าใช้จ่ายที่ใช้ได้ทันทีโดยไม่ต้องรู้อะไรลึก
- วัดก่อนแก้ ใช้
/usageดูว่าเงินหายไปทางไหน แล้วค่อยแก้ตรงจุดนั้น
คำถามที่พบบ่อย
ถ้าใช้แบบ subscription รายเดือน ต้องสนใจเรื่องนี้ไหม
ต้อง เพราะถึงจะไม่ได้จ่ายต่อ token แต่โควตาการใช้งานถูกคำนวณจากหลักการเดียวกัน ยิ่งใช้ token เปลือง ยิ่งชนเพดานเร็ว เทคนิคทั้งหมดในบทความนี้ช่วยให้ใช้งานได้ไกลขึ้นภายในโควตาเท่าเดิม
ควรใช้โมเดลถูกที่สุดตลอดเพื่อประหยัดใช่ไหม
ไม่ใช่ เพราะต้นทุนที่ควรดูคือค่าใช้จ่ายต่องานที่ทำเสร็จ ไม่ใช่ค่าใช้จ่ายต่อหนึ่งคำขอ โมเดลถูกที่ทำงานไม่ผ่านแล้วต้องสั่งใหม่สามรอบ สุดท้ายแพงกว่าโมเดลแพงที่จบในรอบเดียว
compact กับ clear ต่างกันยังไง
/clear คือล้างบทสนทนาทิ้งทั้งหมดแล้วเริ่มใหม่ เหมาะเมื่อเปลี่ยนไปทำงานคนละเรื่อง และไม่เสียเงิน ส่วน /compact คือย่อบทสนทนาเก่าให้สั้นลงแต่ยังเก็บใจความไว้ เหมาะเมื่อยังทำเรื่องเดิมอยู่แต่คุยกันมายาวแล้ว มีค่าใช้จ่ายแต่คืนทุนเร็ว
ทำไมพักเบรกแล้วค่าใช้จ่ายถึงเพิ่ม
เพราะแคชมีอายุ ถ้าเป็น API key แคชอยู่แค่ 5 นาที พอกลับมาคุยต่อ ระบบต้องเขียนแคชใหม่ทั้งก้อน ซึ่งแพงกว่าการอ่านมาก ผู้ใช้แบบ subscription เจอปัญหานี้น้อยกว่าเพราะแคชอยู่ได้ถึง 1 ชั่วโมง
ตัวเลขในบทความนี้เป็นราคาที่คนไทยจ่ายจริงไหม
เป็นราคา list price ของ API ที่ Anthropic ประกาศ คิดเป็นดอลลาร์สหรัฐ ผู้ใช้ทั่วไปที่สมัครแบบรายเดือนจะไม่เห็นตัวเลขเหล่านี้ตรง ๆ แต่ใช้เข้าใจกลไกเบื้องหลังได้ และราคาอาจเปลี่ยนแปลงได้ ควรตรวจสอบกับหน้าราคาทางการก่อนนำไปคำนวณจริง
อ้างอิง
- Anthropic, What a task costs on Opus 5.5
- ภาพถ่ายปกจาก Pexels ภายใต้ Pexels License ซึ่งใช้ได้ฟรีรวมถึงงานเชิงพาณิชย์
- กราฟและแผนภาพทั้ง 5 ภาพในบทความนี้ ทีมงาน IT Genius Engineering จัดทำขึ้นใหม่เป็นภาษาไทยจากตัวเลขที่ระบุในบทความต้นฉบับ
บทความนี้เป็นการเรียบเรียงและเขียนขึ้นใหม่เป็นภาษาไทยโดยทีมงาน IT Genius Engineering ไม่ใช่การแปลตรงตัวจากต้นฉบับ หากต้องการอ่านฉบับเต็มภาษาอังกฤษพร้อมเครื่องมือคำนวณแบบโต้ตอบที่ให้ใส่ตัวเลขของตัวเองได้ สามารถเข้าไปอ่านได้ที่เว็บไซต์ของ Anthropic ตามลิงก์อ้างอิงด้านบน
ไอทีจีเนียส เอ็นจิเนียริ่ง (IT Genius Engineering) ให้บริการด้านไอทีครบวงจร ทั้งงานด้านการอบรม (Training) สัมมนา รับงานเขียนโปรแกรม เว็บไซต์ แอพพลิเคชั่น งานออกแบบกราฟิก และงานด้าน E-Marketing ที่กำลังได้รับความนิยมในปัจจุบัน ทั้ง SEO , PPC , และ Social media marketting
ติดต่อเราเพื่อสอบถามผลิตภัณฑ์ ขอราคา หรือปรึกษาเรื่องไอที ได้เลยค่ะ
Line : @itgenius (มี @ ด้านหน้า) หรือ https://lin.ee/xoFlBFeFacebook : https://www.facebook.com/itgeniusonline
Tel : 02-570-8449 มือถือ 088-807-9770 และ 092-841-7931
Email : contact@itgenius.co.th
แนะนำหลักสูตรอบรมที่น่าสนใจ
Claude Code Roadmap 12 บทเรียนจากพื้นฐานสู่ AI Coding Workflow
Claude Code ไม่ได้เป็นเพียงเครื่องมือสำหรับถาม AI ให้ช่วยเขียนโค้ด แต่ทำหน้าที่เสมือน A...
AI Coding Agent for SDLC พัฒนาซอฟต์แวร์ครบวงจรด้วย AI Agent
นักพัฒนาส่วนใหญ่ใช้ AI ช่วยเขียนโค้ดกันแล้ว แต่ยังใช้แบบสั่งทีละงานแล้วคัดลอกผลลัพธ์มาว...

AI Literacy รู้จักและใช้ AI ในการทำงาน
AI กลายเป็นเครื่องมือพื้นฐานในที่ทำงานไปแล้ว แต่พนักงานจำนวนมากยังไม่รู้ว่าจะเริ่มใช้อย...
AI Fullstack Web Builder จากศูนย์สู่ Production ด้วย AI Agent
หลักสูตรนี้พาผู้เรียนเดินทางครบเส้นทางในสองวัน จากคนที่ยังไม่เคยเขียนโปรแกรมมาก่อน ไปจน...
คำค้นหา : Opus 5.5Claudeค่าใช้จ่าย AItokenprompt cachingeffortClaude CodeAI codingลดต้นทุน AIAnthropic